- 06 de out
O Paradoxo de Simpson
- Fernando Amaral
Todo mundo já ouviu que correlação não é causalidade. É a primeira falha do raciocínio baseado em dados, e quase todos a reconhecem. Mas existe uma segunda, bem mais traiçoeira, às vezes a própria correlação muda de sinal dependendo de como você olha para os dados.
Antes de continuar, um aviso: raciocinar com atalhos não é pecado. Eu mesmo faço isso o tempo todo, porque pensar de forma eficiente também importa. Mas é bom saber onde o atalho quebra.
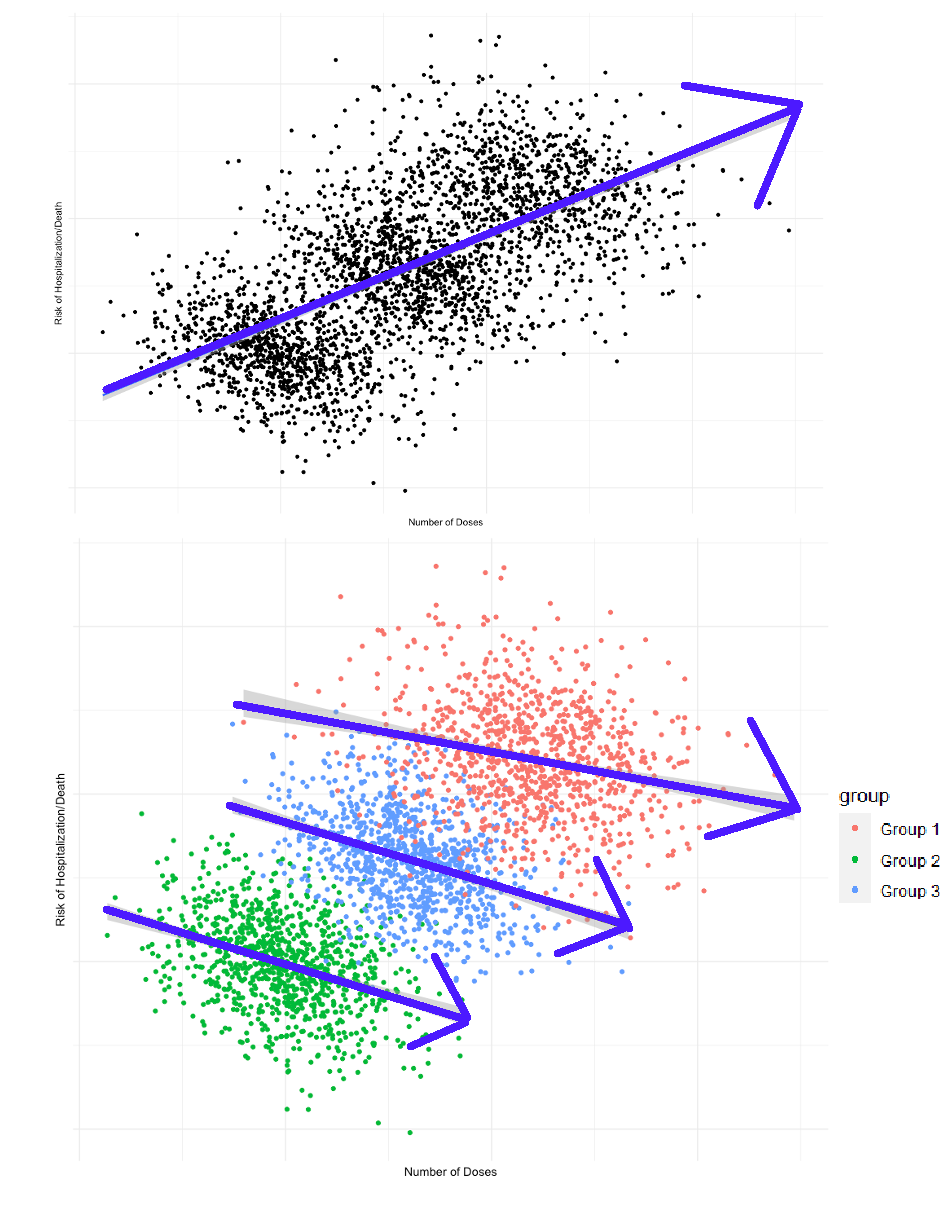
credito: https://epiren.medium.com/when-things-arent-what-they-seem-simpson-s-paradox-d3c3e5fdd6cf
Um exemplo:
Você junta dados de estudantes e plota horas de estudo × nota. A linha desce: quanto mais se estuda, menor a nota. Conclusão óbvia: "estudar demais atrapalha"?
Agora separe os mesmos dados por nível de dificuldade do conteúdo (básico, intermediário, avançado). Dentro de cada nível, a linha sobe: mais estudo, nota maior.
Os dois gráficos estão corretos. O que aconteceu é que quem estuda por muito tempo geralmente já está em conteúdos mais difíceis, e conteúdos difíceis rendem notas menores. A dificuldade cresce junto com as horas de estudo e puxa a média geral para baixo. Misturando tudo, ela esconde o efeito real do estudo.
Isso é o Paradoxo de Simpson
Com exatamente o mesmo conjunto de dados, a estatística sustenta duas conclusões opostas:
"O grupo X=1 tem mais chance de Y do que o grupo X=2"
"O grupo X=2 tem mais chance de Y do que o grupo X=1"
Qual das duas você enxerga depende de qual terceira variável você decide fixar. Os números não erram, a interpretação é que pode errar.
Não é teoria. Em 1973, Berkeley parecia admitir proporcionalmente mais homens do que mulheres. Ao olhar departamento por departamento, Bickel, Hammel e O'Connell (1975) mostraram que as mulheres tinham taxas iguais ou melhores na maioria deles. Elas apenas se candidatavam mais a cursos muito concorridos.
Então qual gráfico está certo?
Os dados sozinhos não respondem. Segundo Judea Pearl (2014), quem decide se devemos olhar o dado agregado ou segmentado é o modelo causal: se a terceira variável influencia as duas grandezas comparadas, ela precisa ser controlada. Se for consequência delas, controlá-la pode ser o erro. É preciso entender como o mundo funciona, e isso nenhuma tabela entrega sozinha.
Como se proteger
Desconfie de médias agregadas quando existirem subgrupos naturais.
Pergunte: o que mais muda junto com isso?
Segmente, mas com um modelo causal em mente, não no automático.
Resumo
Ser "data-driven" é fácil. Ser data-driven sem cair em armadilhas pode dar trabalho.
Referências
Simpson, E. H. (1951). "The Interpretation of Interaction in Contingency Tables." Journal of the Royal Statistical Society, Series B, 13(2), 238–241.
Yule, G. U. (1903). "Notes on the Theory of Association of Attributes in Statistics." Biometrika, 2(2), 121–134.
Bickel, P. J.; Hammel, E. A.; O'Connell, J. W. (1975). "Sex Bias in Graduate Admissions: Data from Berkeley." Science, 187(4175), 398–404.
Pearl, J. (2014). "Understanding Simpson's Paradox." The American Statistician, 68(1), 8–13.
